影刀RPA 数据湖自动化HDFS S3原始数据存储与管理什么情况用什么 → 怎么做 → 有什么坑作者林焱 | 飞行社出品什么情况用什么企业数据量爆炸MySQL存不下、查不动需要建数据湖存原始数据但又不想手动管理HDFS/S3。这套方案适合大数据团队自动化数据湖管理定时从业务库增量同步到数据湖数据湖权限与生命周期自动化管理核心工具影刀RPA boto3S3 hdfsHDFS 元数据管理怎么做第一步自动化上传原始数据到S3数据湖店群矩阵自动化突破运营极限importboto3importosfromdatetimeimportdatetimeimportjsondefupload_to_data_lake(bucket_name,local_path,partition_cols): 上传数据到数据湖S3按日期分区 partition_cols: 分区字段如 [year, month, day] sessionboto3.Session(profile_nameyour-profile)s3session.client(s3)# 按日期分区组织路径todaydatetime.now()partition_pathfyear{today.year}/month{today.month}/day{today.day}/# 上传文件ifos.path.isfile(local_path):s3_keyfraw/{partition_path}{os.path.basename(local_path)}s3.upload_file(local_path,bucket_name,s3_key)print(f✅ 上传成功: s3://{bucket_name}/{s3_key})returnfs3://{bucket_name}/{s3_key}elifos.path.isdir(local_path):uploaded[]forroot,_,filesinos.walk(local_path):forfileinfiles:local_fileos.path.join(root,file)relative_pathos.path.relpath(local_file,local_path)s3_keyfraw/{partition_path}{relative_path}s3.upload_file(local_file,bucket_name,s3_key)uploaded.append(fs3://{bucket_name}/{s3_key})print(f✅ 批量上传成功:{len(uploaded)}个文件)returnuploaded# 使用示例upload_to_data_lake(bucket_namecompany-data-lake,local_path/data/orders/2026-06-28.csv,partition_cols[year,month,day])第二步HDFS数据湖自动化管理importpyarrowaspaimportpyarrow.parquetaspqfrompyarrowimportfsimportpandasaspdclassHDFSDataLakeManager:HDFS数据湖管理器def__init__(self,hdfs_hostlocalhost,hdfs_port8020):self.hdfsfs.HadoopFileSystem(hosthdfs_host,porthdfs_port)print(f✅ HDFS连接成功:{hdfs_host}:{hdfs_port})defupload_parquet(self,local_df,hdfs_path,partition_colsNone): 上传DataFrame到HDFSParquet格式列式存储 partition_cols: 分区字段如 [year, month] try:# 转换DataFrametablepa.Table.from_pandas(local_df)# 写入HDFSifpartition_cols:pq.write_to_dataset(table,root_pathhdfs_path,partition_colspartition_cols,filesystemself.hdfs)else:pq.write_table(table,hdfs_path,filesystemself.hdfs)print(f✅ 数据已写入HDFS:{hdfs_path})returnTrueexceptExceptionase:print(f❌ 写入HDFS失败:{e})returnFalsedefread_parquet(self,hdfs_path,filtersNone):从HDFS读取Parquet文件try:tablepq.read_table(hdfs_path,filtersfilters,filesystemself.hdfs)dftable.to_pandas()print(f✅ 数据已读取:{len(df)}行)returndfexceptExceptionase:print(f❌ 读取HDFS失败:{e})returnNone# 使用示例dfpd.DataFrame({order_id:[1,2,3],amount:[100.0,200.0,300.0],year:[2026,2026,2026],month:[6,6,6]})managerHDFSDataLakeManager()manager.upload_parquet(df,/data-lake/orders,partition_cols[year,month])第三步数据湖元数据自动化管理defmanage_data_lake_metadata(bucket_name,database_name,table_name): 使用AWS Glue Data Catalog管理数据湖元数据 让Athena/Presto可以直接查询S3上的数据 importboto3 glueboto3.client(glue,region_namecn-north-1)# 1. 创建数据库如果不存在try:glue.create_database(DatabaseInput{Name:database_name,Description:f数据湖数据库:{database_name}})print(f✅ 数据库已创建:{database_name})exceptglue.exceptions.AlreadyExistsException:print(fℹ️ 数据库已存在:{database_name})# 2. 创建表指向S3路径try:glue.create_table(DatabaseNamedatabase_name,TableInput{Name:table_name,StorageDescriptor:{Location:fs3://{bucket_name}/raw/,InputFormat:org.apache.hadoop.mapred.TextInputFormat,OutputFormat:org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat,SerdeInfo:{SerializationLibrary:org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe},Columns:[{Name:order_id,Type:bigint},{Name:amount,Type:double},{Name:year,Type:int},{Name:month,Type:int},{Name:day,Type:int}]},PartitionKeys:[{Name:year,Type:int},{Name:month,Type:int},{Name:day,Type:int}]})print(f✅ 表已创建:{database_name}.{table_name})exceptglue.exceptions.AlreadyExistsException:# 更新表glue.update_table(DatabaseNamedatabase_name,TableInput{...}# 同上的TableInput)print(f✅ 表已更新:{database_name}.{table_name})# 在影刀RPA中调用manage_data_lake_metadata(bucket_namecompany-data-lake,database_nameraw_data,table_nameorders)第四步数据湖生命周期自动化管理defsetup_data_lake_lifecycle(bucket_name):设置S3数据湖生命周期策略importboto3 s3boto3.client(s3)# 生命周期规则lifecycle_config{Rules:[{ID:raw-data-transition,Status:Enabled,Transitions:[{Days:30,StorageClass:STANDARD_IA# 30天后转低频访问},{Days:60,StorageClass:GLACIER# 60天后转冷备份}],Prefix:raw/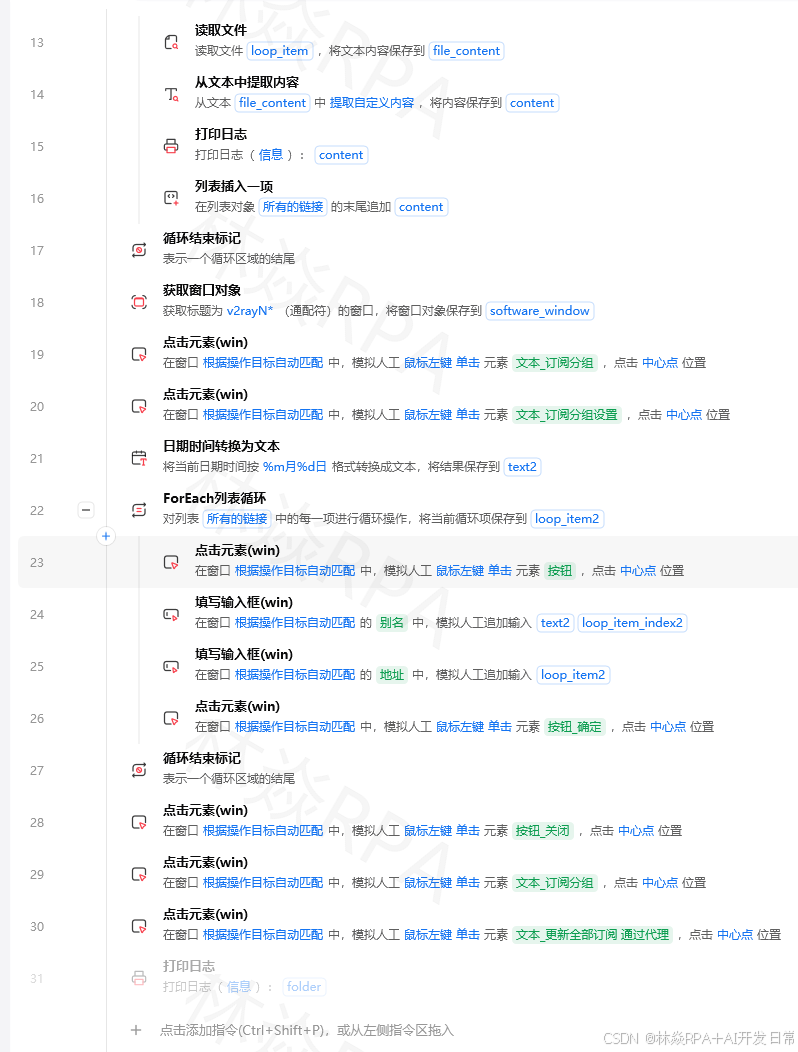},{ID:processed-data-expiration,Status:Enabled,Expiration:{Days:365# 1年后删除},Prefix:processed/}]}s3.put_bucket_lifecycle_configuration(Bucketbucket_name,LifecycleConfigurationlifecycle_config)print(f✅ 生命周期策略已设置:{bucket_name})# 在影刀RPA中调用setup_data_lake_lifecycle(company-data-lake)第五步影刀RPA完整流程编排【定时触发】每天凌晨2:00 ↓ 【Python节点】extract_increment_data() → 从业务库抽取增量数据 ↓ 【Python节点】transform_to_parquet() → 转换为Parquet格式 ↓ 【Python节点】upload_to_data_lake() → 上传到S3数据湖 ↓ 【Python节点】manage_data_lake_metadata() → 更新Glue元数据 ↓ 【条件判断】是否上传成功 ├─ 是 → 【企微通知】发送✅ 数据湖同步成功 └─ 否 → 【企微通知】发送❌ 数据湖同步失败 ↓ 【Python节点】setup_data_lake_lifecycle() → 应用生命周期策略 ↓ 【写入Excel】更新数据湖管理日志.xlsx有什么坑坑1小文件问题Small Files Problem如果你每条数据写一个文件到数据湖会产生海量小文件查询性能极差。解决方案# 错误做法每条数据写一个文件fororderinorders:write_to_s3(forder_{order.id}.json,order.to_json())# ❌ 小文件# 正确做法批量合并后再写batch_size1000foriinrange(0,len(orders),batch_size):batchorders[i:ibatch_size]write_to_s3(forders_{i//batch_size}.parquet,pd.DataFrame(batch))# ✅ 大文件坑2数据分区不合理查询扫描全表如果按created_at分区但查询常用user_id过滤会导致全表扫描。解决方案** 按查询常用字段分区**# 错误做法按创建时间分区但查询常用user_idpartition_by[created_year,created_month]# ❌# 正确做法按查询常用字段分区partition_by[user_id_hash]# ✅ 查询快# 或者组合分区partition_by[created_year,user_id_hash]# ✅ 平衡坑3数据湖Schema EvolutionSchema演化问题最初表结构是(order_id, amount)后来加了discount字段旧数据读不出来。temu店群自动化报活动案例解决方案** 使用Schema Evolution兼容的数据格式**# Parquet Spark 支持Schema Evolutionfrompyspark.sqlimportSparkSession sparkSparkSession.builder.appName(DataLake).getOrCreate()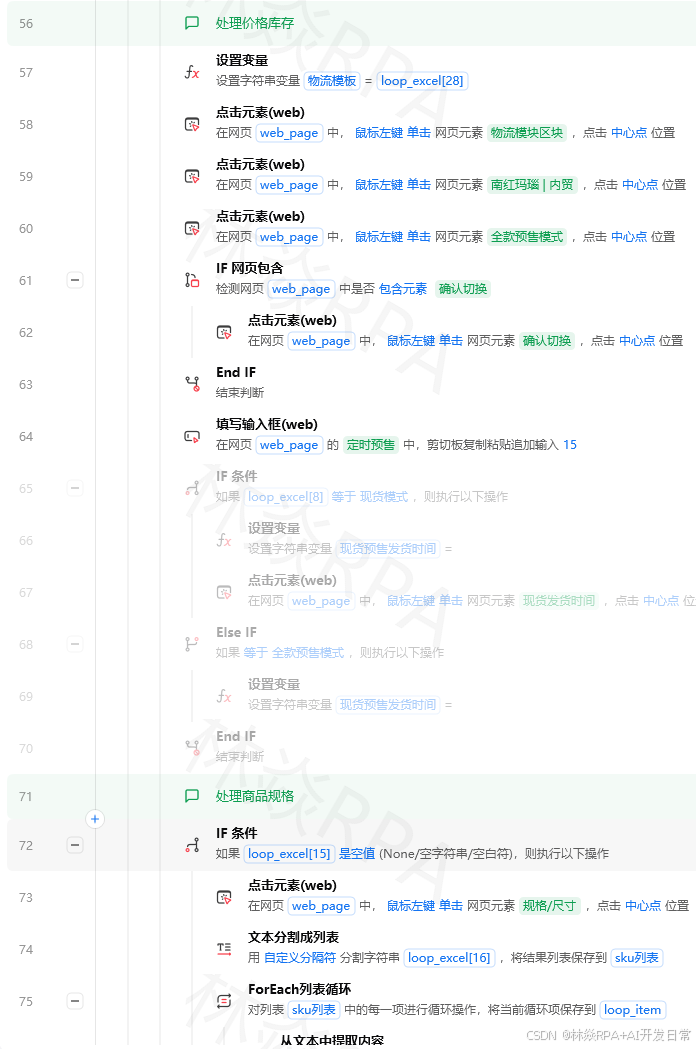# 读取时合并Schemadfspark.read.option(mergeSchema,true).parquet(s3://bucket/table/)坑4数据湖权限管理混乱数据湖里存了所有部门的原始数据但没做权限控制销售能看财务数据。解决方案** 使用AWS Lake Formation做细粒度权限控制**importboto3 lfboto3.client(lakeformation)# 授权销售部门只能看自己的数据lf.grant_permissions(Principal{DataLakePrincipalIdentifier:sales-department},Resource{Table:{DatabaseName:raw_data,TableName:orders}},Permissions[SELECT],Condition{Expression:user_id current_user()}# 行级权限)总结功能节省时间附加价值自动上传到数据湖每天省1小时数据不丢失可回溯元数据自动管理每次省30分钟数据可被直接查询生命周期管理每月省2小时存储成本降低70%权限自动化—数据安全合规实际落地建议先小范围测试选1张表试点验证流程稳定性使用Parquet格式比CSV节省80%存储空间做好Schema管理用Glue Schema Registry管理版本定期优化用OPTIMIZE命令合并小文件数据湖自动化能为数据团队节省60%以上的数据管理时间同时降低存储成本70%。
✦ 本文为尧图网络原创建站知识分享。想针对自身行业获取定制化建站方案?欢迎咨询,资深顾问免费为你出思路。